
Sieben Teile, ein Score
Aktualisiert: 16. Sept.
DATABRICKS PLATFORM REVIEW
Wie ein Well-Architected Review einer Databricks-Plattform zusammenpasst — und warum Sie es in Teilen durchführen sollten.
Th4mat Robotik GmbH · Beratung für Datenplattformen und Plattformsicherheit
Architektur-Reviews scheitern meist auf eine von zwei Arten. Entweder entsteht ein sechzigseitiges PDF, das niemand ein zweites Mal öffnet — oder ein Urteil („sieht gut aus“), das genau bis zum ersten Vorfall hält. Beides hat denselben Grund: „Ist unsere Plattform gut architektiert?“ ist eine zu große Frage, um sie in einer Sitzung, von einer Person, mit einer Zahl zu beantworten.
Das Databricks Well-Architected Framework zerlegt diese Frage. Sieben Säulen, jede für einen eigenen Betrachtungsbereich, jede unterteilt in Prinzipien und daraus abgeleitete konkrete Best Practices. Unser Review folgt dieser Struktur exakt — sieben Teile, 30 Prinzipien, 185 Best Practices. Sie können einen Teil heute Nachmittag durchgehen und den Rest nächsten Monat; die Zahlen passen trotzdem zusammen.
Dieser Beitrag zeigt, was jeder Teil abfragt, wo sich die Teile bewusst überschneiden und wie aus sieben einzelnen Scores ein Plattform-Score wird, ohne das Ergebnis zu beschönigen.
Zwei Säulen für das Lakehouse, fünf aus der Cloud
Fünf der sieben Säulen kennt jeder, der mit den Well-Architected Frameworks von AWS, Azure oder Google gearbeitet hat: Operational Excellence, Security, Reliability, Performance Efficiency und Cost Optimization. Das Lakehouse übernimmt ihre Zielsetzung unverändert. Die Details unterscheiden sich, denn eine Plattform, deren Arbeitseinheit eine Tabelle und ein Job ist, ist keine Plattform, deren Arbeitseinheit eine virtuelle Maschine ist.
Zwei Säulen sind lakehouse-spezifisch und haben kein Cloud-Pendant:
• Data and AI Governance — ob Daten Wert schaffen und die Geschäftsstrategie stützen. Praktisch gefragt: Gibt es ein Governance-Modell, das jede Tabelle, jedes Modell, jedes Volume und jedes Dashboard erfasst — oder sieben Modelle und eine Excel-Liste?
• Interoperability and Usability — ob die Plattform für die Menschen und Systeme erreichbar ist, die sie brauchen, auf offenen Formaten, ohne Ticket an das Plattform-Team.
An diesen beiden Säulen kommen Lakehouse-Programme unbemerkt zum Stillstand. An den fünf gemeinsamen Säulen scheitern sie sichtbar.
Was die einzelnen Teile abfragen
Teil | Säule | Practices | Wer dabei sein sollte | Dauer |
1 | Data and AI Governance | 13 | Plattform-Owner, Data-Governance-Verantwortliche | 15–30 Min. |
2 | Interoperability and Usability | 15 | Plattform-Owner, Lead Data Engineer | 20–35 Min. |
3 | Operational Excellence | 21 | Plattform- bzw. DevOps-Engineer | 25–45 Min. |
4 | Security, Compliance and Privacy | 75 | Security-Verantwortliche, Plattform-Admin, Cloud-Networking | 2–3 Sitzungen |
5 | Reliability | 18 | Lead Data Engineer, Rufbereitschaft | 20–35 Min. |
6 | Performance Efficiency | 24 | Data bzw. Analytics Engineer | 25–45 Min. |
7 | Cost Optimization | 19 | Plattform-Owner, FinOps oder Controlling | 20–40 Min. |
Die Zeitangaben setzen voraus, dass jemand im Raum ist, der die Plattform wirklich kennt; es sind Interview-Zeiten, keine Analysezeiten. Teil 4 ist fünfmal so umfangreich wie Teil 1, weil das Framework bei Sicherheit am weitesten ins Detail geht — 75 Best Practices zu Identität, Datenschutz, Netzwerk, Compliance und Monitoring. In einer Sitzung ist das selten zu schaffen, und ohne das Security-Team sollte man es gar nicht erst beginnen.
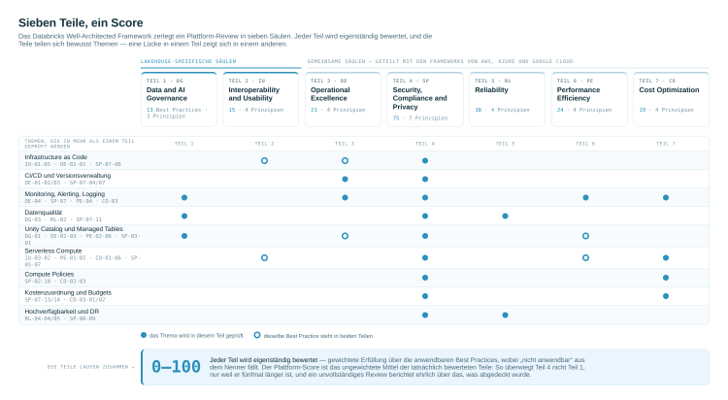
Die sieben Teile, ihre gemeinsamen Themen und wie sie zu einem Plattform-Score zusammenlaufen.
Wo sich die Teile bewusst überschneiden
Die sieben Teile sind keine sieben getrennten Audits. Sie teilen sich Themen — und diese Überschneidungen sind der aufschlussreichste Teil der Übung.
Drei Best Practices tauchen wortgleich in jeweils zwei Säulen auf:
• Use infrastructure as code (IaC) for deployments and maintenance ist eine Interoperabilitäts-Practice (IU-01-05) und eine operative (OE-02-01) — und erscheint ein drittes Mal als Sicherheitskontrolle (SP-07-06), weil überprüfter Code der Weg ist, auf dem eine Sicherheitseinstellung aufhört, das Gedächtnis einer einzelnen Person zu sein.
• Use serverless compute ist eine Usability-Practice (IU-03-02), eine Performance-Practice (PE-01-01) und eine Kosten-Practice (CO-01-06).
• Use Unity Catalog managed tables ist eine operative Practice (OE-02-03) und eine Performance-Practice (PE-02-06).
Dazu kommen die thematischen Nahtstellen. Monitoring taucht in fünf der sieben Teile auf. Datenqualität wird in der Governance definiert (DG-03) und in der Reliability durchgesetzt (RL-02). Disaster Recovery ist ein Reliability-Muster (RL-04) und zugleich eine Compliance-Pflicht (SP-06-09). Kostenzuordnung ist eine Kosten-Practice (CO-03) und ein Sicherheitssignal (SP-07-13/14) — ein unerklärter Kostenanstieg ist oft der erste Hinweis auf Missbrauch.
Deshalb ist ein einzelner schwacher Score selten ein einzelnes Problem. Fällt Teil 3 bei Compute Policies schwach aus, wird Teil 7 bei der Kostenkontrolle schwach ausfallen und Teil 4 bei Identity — dieselbe fehlende Policy richtet an drei Stellen Schaden an. Erst die getrennte Bewertung und die gemeinsame Lektüre machen das sichtbar. |
Wie aus sieben Scores einer wird
Jede Best Practice wird als umgesetzt, teilweise umgesetzt, nicht umgesetzt oder nicht anwendbar erfasst — mit einem Freitextfeld für den Nachweis. Daraus ergibt sich:
• Umgesetzt zählt 1,0; teilweise 0,5; nicht umgesetzt 0.
• Nicht anwendbar fällt vollständig aus dem Nenner. Eine Plattform ohne ML-Workloads wird nicht dafür bestraft, keine Model Registry zu betreiben.
• Jede Best Practice hat eine Gewichtung — kritisch, hohe Wirkung oder Standard. Ein fehlender Disaster-Recovery-Plan und ein fehlender Tabellenkommentar sind nicht dieselbe Feststellung.
• Der Score eines Teils ist die gewichtete Erfüllung über den gewichteten anwendbaren Umfang, auf einer Skala von 0 bis 100.
• Der Plattform-Score ist das ungewichtete Mittel der bewerteten Teile. Bewusst nicht gewichtet: sonst würden die 75 Punkte aus Teil 4 die übrigen sechs überdecken, und eine Plattform mit exzellenter Sicherheit und ohne Kostenkontrolle erschiene gesund.
Zwei Konsequenzen, die man klar benennen sollte. Ein noch nicht begonnener Teil zählt nicht als Null — er zählt gar nicht, und die Auswertung nennt, auf wie vielen Teilen der Score beruht. Und ein Teil, in dem alles als nicht anwendbar markiert ist, ergibt keinen Score statt eines perfekten.
Die Bänder: ab 85 „on track“, 70 bis 84 „einzelne Wachstumsfelder“, unter 70 „Handlungsbedarf“. Diese Schwellen und die Gewichtungen sind unsere fachliche Einschätzung — Databricks veröffentlicht die Best Practices, kein Bewertungsschema. Wir schreiben das in die Auswertung, damit die Zahl der ersten Rückfrage im Raum standhält.
Das Review in Teilen fahren
Bewährte Reihenfolgen:
• Gesamte Plattform, erstes Mal. Zuerst Teil 1 und 3 — Governance und Operational Excellence legen das Vokabular fest, das alles Weitere benutzt. Dann Teil 4, dann der Rest.
• Kostendruck. Teil 7, dann Teil 3. Die meisten Kostenbefunde sind am Ende Compute Policies und Runtime-Versionen — und die liegen in der Operational Excellence.
• Vor einem Audit. Teil 4 allein, danach Teil 1 und Teil 5 für die Nachweis- und Wiederherstellungsfragen, die als Nächstes kommen.
• Nach einem Vorfall. Teil 5, dann Teil 3.
Da jeder Teil eigenständig bewertet wird, ist auch ein Teil-Review ein belastbares Ergebnis — die Abdeckung steht auf der Scorecard, statt darin unterzugehen.
Was der Score nicht ist
Er ist keine Zertifizierung und kein Databricks-Produkt. Er ist eine strukturierte Lesart einer Plattform entlang eines veröffentlichten Frameworks, ergänzt um unsere Gewichtung.
Databricks überarbeitet das Framework. Seit der Fassung vom Dezember 2024 ist in der Säule Reliability „Create regular backups“ entfallen, und Hochverfügbarkeit wurde von Disaster Recovery getrennt; Cost Optimization hat sein komplettes Monitoring-Prinzip durch Budgets und Usage Policies ersetzt; die Security-Säule ist von sieben auf fünf Prinzipien geschrumpft. Unsere Codes — DG-01-01 und so weiter — bleiben über diese Überarbeitungen stabil, damit sich eine Wiederholung sauber mit der letzten vergleichen lässt. Die Titel in der Dokumentation bleiben es nicht.
Fangen Sie mit einem Teil an
Wählen Sie die Säule, die Sie gerade etwas kostet — Geld, Schlaf oder die Aufmerksamkeit eines Prüfers — und fahren Sie diesen einen Teil. Ein Nachmittag liefert einen Score, eine nach Phasen sortierte Liste von Feststellungen mit den zugehörigen Nachweisen und eine klare Antwort darauf, ob der nächste Teil die Zeit wert ist.
Wir speichern die Ergebnisse nicht, aber freuen uns für dein Feedback.
Link zum Tool: Databricks Platform Review Tool Deutsch | Th4mat
Die Th4mat Robotik GmbH berät zu Databricks-Datenplattformen und Plattformsicherheit. Wenn Sie das Review gemeinsam durchführen möchten oder das Werkzeug für Ihr eigenes Team brauchen, schreiben Sie uns: info@th4mat.de.

Kommentare